
Distribuição normal: aquela curva entediante, simétrica e chata… que, ironicamente, explica quase tudo no mundo. Vai entender essa maluquice.
📈 Distribuição normal: a ‘popzinha’da estatística
A distribuição normal é a rainha soberana do mundo probabilístico.
A distribuição normal está em toda parte: no ruído do rádio, nos erros dos cientistas, no tamanho das sardinhas e, claro, nas notas das provas que ninguém estudou.
Se existe alguma lei universal nas ciências exatas e naturais, é que tudo tende a virar uma curva em forma de sino se você observar com paciência e amostragem suficiente.
E se não virar? Bem, aí você provavelmente está analisando dados errados.
A curva da distribuição normal é tão central no universo estatístico que deveria cobrar royalties.
Com seus ombros suaves e cauda infinita, ela descreve o comportamento de variáveis aleatórias com uma desenvoltura matemática que só não é mais bela porque ninguém tem tempo de olhar fórmulas às 2 da manhã antes da prova.
Mas não se engane com seu charme gráfico.
Por trás dessa simetria zen mora uma fórmula que mistura π (o número irracional que assombra você desde a 7ª série), o e (que não é de “esperança”, mas da base dos logaritmos naturais), e μ e σ, que são só nomes chiques para média e desvio padrão.
Tudo isso envolvido numa exponencial maluca que define o seguinte:
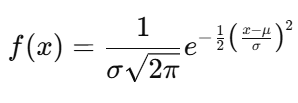
Bonito, né? Parece que saiu direto de um pesadelo de Cálculo III.
🎩 O passado glorioso (e nerd) da Curva de Gauss
Se você acha que a distribuição normal é invenção de professor de cursinho, está enganado.
Sua gênese vem de uma época em que as pessoas usavam perucas brancas, escreviam com penas e descobriam fórmulas entre guerras napoleônicas.
- Tudo começa em 1733, quando Abraham de Moivre teve a brilhante ideia de prever resultados de cara ou coroa usando fatoriais gigantes e um pouco de coragem matemática. Ele nem sabia, mas estava abrindo o caminho para o Teorema Central do Limite, o verdadeiro plot twist da estatística.
- Depois veio Laplace (sim, aquele da “Transformada”) e disse: “Deixa eu melhorar isso aqui com umas integrais cabulosas.” Resultado? Ele criou a primeira tabela de distribuição normal lá em 1781 — sem Excel, sem Python, só com suor e tinta.
- E claro, não podemos esquecer do queridinho dos professores de física e matemática: Carl Friedrich Gauss. Ele apareceu em 1809, olhou para os erros das observações astronômicas e disse: “Ah, isso aqui tem cara de sino.” E pronto, a curva virou “curva de Gauss”.
Ah, e só pra constar: o nome “distribuição normal” só foi surgir no final do século XIX, dado por Henri Poincaré, possivelmente porque “curva de sino com propriedades assintóticas agradáveis” não vendia bem.
🧠 Moral da história
A distribuição normal não é apenas uma fórmula cheia de sopa de letrinhas — ela é o padrão ouro quando o assunto é comportamento agregado de dados aleatórios.
Você joga um dado uma vez e não vê nada.
Joga mil vezes e… pá! Lá está ela: a curva da distribuição normal, dizendo “eu te disse”.
Ela aparece no movimento browniano, no ruído branco, nas provas padronizadas, nos erros de medição e até em memes estatísticos.
E se um fenômeno não segue uma distribuição normal, os estatísticos tentam torturá-lo até que confesse.
📏 Distribuição normal padrão: a versão fitness da curva normal
Pense na distribuição normal como uma diva estatística.
Agora imagine essa diva depois de um treino funcional e uma dieta baseada em integrais: essa é a distribuição normal padrão.
Ela é a versão zero açúcar da distribuição normal, com média igual a 0 (ou seja, centrada no nada, tipo sua motivação às segundas-feiras) e desvio padrão igual a 1 (ou seja, com a variação de um estudante tentando entender derivadas pela primeira vez).
A função de densidade fica assim:
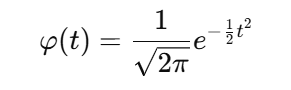
Uma fórmula que grita: “Sou simétrica e gosto de limites indo ao infinito!”.
É a curva de Gauss, também conhecida como a famigerada curva em forma de sino.
Só que, diferentemente de sinos reais, esse aqui não faz barulho — ele só te julga silenciosamente quando você tira 2 numa prova que tinha média 7.
🧮 Escores-z: GPS estatístico
Quer saber onde você está na distribuição normal?
Bem-vindo ao mundo dos escores-z.
Eles dizem quantos desvios padrão um valor está distante da média — ou seja, quanto você se afastou do “normal”.
Fórmula do escore-z:
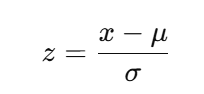
Ou seja: você pega seu valor (x), subtrai a média (μ) e divide pelo desvio padrão (σ).
Resultado? Um número que diz basicamente se você é mediano, estranho, ou muito, muito fora da curva.
Se você tirou um z = 2, parabéns, você está duas unidades de desvio acima da média — isso pode significar que você foi bem na prova ou que é estatisticamente suspeito.
📊 Propriedades da normal padrão (aka: o manual de instruções do sino)
- Para z = 0, a área acumulada é 0,5. Ou seja, 50% dos dados estão abaixo da média.
- Para z ≈ -3,49 → área ≈ 0 (você é um outlier triste).
- Para z ≈ +3,49 → área ≈ 1 (você é um outlier feliz).
- A função é simétrica (espelho perfeito em relação ao centro).
- Ela tem pontos de inflexão em z = -1 e z = 1, o que na prática significa: “a partir daqui o negócio começa a ficar estranho”.
🔮 A função distribuição: a bola de cristal probabilística
A função distribuição Φ(x) responde à pergunta: qual a probabilidade de um valor estar abaixo de x?
A fórmula é legal, mas impossível de resolver na unha:
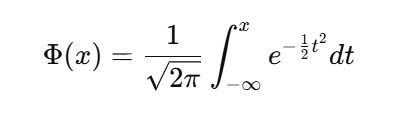
Traduzindo: não tente calcular isso sem uma calculadora ou uma tabela de valores.
A não ser que você queira desenvolver trauma de integrais.
Aliás, você pode substituir Φ(x) pela função erro (erf), que é igualmente incompreensível à primeira vista:
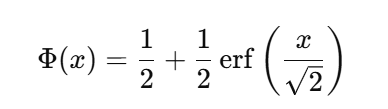
Mas o mais importante é: essa função te dá a probabilidade acumulada até certo ponto z.
Se você quer saber qual a chance de um aluno aleatório ter nota menor que 1,2 desvios padrão acima da média, a Φ te responde.
🧠 Função característica: a querida dos teóricos (e dos matemáticos que amam sofrimento)
A função característica é tipo aquele aluno que parece inútil na escola, mas que secretamente sabe tudo, resolve tudo, e você só entende a genialidade dele depois da graduação.
Ela não serve pra “ver” a distribuição como a densidade faz, mas sim pra provar coisas absurdamente importantes, tipo o Teorema Central do Limite.
📌 Definição oficial:
A função característica da distribuição normal padrão é:
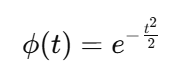
Simples, direta e sem firulas.
Mas por trás desse ar minimalista, essa função é um canivete suíço estatístico.
Quer saber como a soma de variáveis se comporta?
Quer provar que algo converge pra uma normal? Pergunte pra ela.
🤯 Como ela aparece na prática?
Se você tem uma variável aleatória X∼N(0,1), e faz uma transformação linear daquelas tipo: Y=aX+b.
A função característica de Y vai ser:
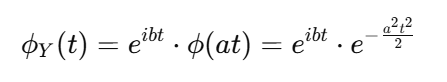
Ou seja, ela te dá a nova função característica só com um trocadilho algébrico.
Resultado? Você prova que Y∼N(b,a2) só usando essa função.
É tipo hackear a vida estatística.
⚠️ Aviso:
Essa ϕ aqui é diferente da densidade φ.
Parece a mesma letra, mas é grego – literalmente.
Uma é o phi de densidade, a outra é o phi de Fourier.
Use com cuidado, ou você pode invocar Gauss e deixar ele decepcionado.
🎭 Função geradora de momentos: a exibida com propósito
A função geradora de momentos (M) é tipo aquela influencer que adora mostrar seus momentos (literalmente): média, variância, curtidas por post, engajamento por minuto…
📌 Definição:
Para a normal padrão X∼N(0,1)
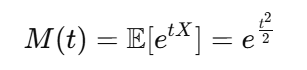
Sim, é parecida com a função característica, mas sem o número imaginário.
Isso porque ela serve pra outra coisa: descobrir momentos da distribuição (média, variância, etc.) com uma derivada aqui, outra ali.
📦 Como funciona:
A regra é: derive M(t) n vezes e avalie em t = 0. O que você ganha?
- Primeira derivada? Média.
- Segunda derivada? Variância + (média)².
- Terceira? Skewness.
- E assim vai…
Ela é tipo o currículo completo da sua distribuição em forma de função.
Quer impressionar com uma transformação?
Se você tem Y=aX+b, a função geradora de momentos de Y é:
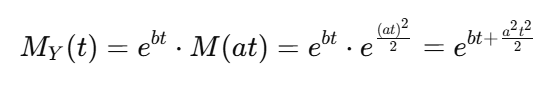
Ou seja: Y tem média = b e variância = a², e a função geradora entrega isso de bandeja como se fosse fácil.
Ela é grande, sim, mas resolve ‘quase’ tudo.
🧪 ‘Mural’ da história:
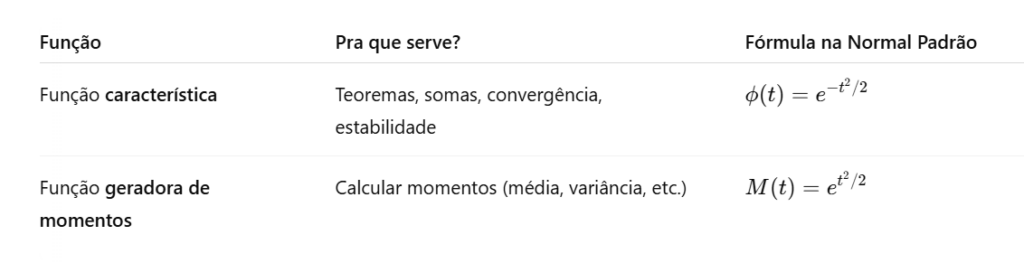
Ambas são fórmulas mágicas, mas de usos diferentes:
- A característica é mais teórica e poderosa nos bastidores.
- A geradora é mais prática, principalmente em cursos de estatística 1.
🧠 Distribuição normal geral – ou a musa dos estatísticos
Distribuição normal é quela curva em forma de sino que aparece mais do que seu chefe no grupo de WhatsApp da firma.
Ela não é só “bonita” no gráfico — é o centro do universo estatístico.
Literalmente.
Se alguma coisa acontece com muita frequência e tem um mínimo de lógica, alguém vai tentar te convencer de que ela “segue uma normal”.
Às vezes segue, às vezes só parece.
📏 A fórmula da densidade? Um clássico do terror:
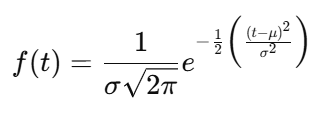
Parece uma poção mágica?
Pois é, mas isso só serve para dizer o seguinte: quanto mais perto de μ (a média), maior a chance de um valor acontecer.
Mais longe? A chance cai como sua esperança numa segunda-feira.
🧮 E a função de distribuição acumulada?
Essa é a que diz “qual a probabilidade de um valor ser menor ou igual a x?”.
E claro, ela envolve uma integral impossível de resolver na unha.
Mas quem se importa, né? A gente joga no software e finge que entendeu.
✨ O que você precisa saber para parecer menos tonto numa reunião:
- μ (mi) é a média. O centro da curva. O “ponto de equilíbrio”.
- σ (sigma) é o desvio padrão. A medida do caos, da bagunça, da “espalhabilidade” dos dados.
- σ²? Só a variância, ou seja, o quadrado do caos.
- A distribuição normal é chamada de N(μ, σ²). Parece um nome de robô, mas é só estatística mesmo.
🤯 Observações que você deveria tatuar na alma:
- Toda normal é filha da normal padrão.
Sim, qualquer N(μ, σ²) pode ser obtida transformando a famigerada N(0, 1) com uma fórmula que lembra uma maquiagem estatística: Y=μ+σX - A chance de X ser exatamente igual a qualquer valor é 0.
Sim, zero. Pode até parecer injusto, mas é verdade. Porque estamos no mundo contínuo, meu caro. - A curva é simétrica. Ou seja, ela é tão equilibrada que daria aula de ioga. O pico é sempre em μ, e a curva tem dois pontos de inflexão em μ ± σ.
- Largura à meia altura? Isso aqui é estatística ou engenharia de som? Mas enfim, saiba que é mais ou menos 2,3548σ.
🤹 Momentos, cumulantes, geradores e outras palavras que traumatizam:
- Os momentos centrais contam coisas como a média, a variância, a simetria e a curtose.
- A curtose normal é 3. Se for maior, cauda pesada. Se for menor, cauda magrinha.
- Leptocúrtica = drama pesado (cauda gorda).
- Platicúrtica = sem sal (cauda fina).
- Mesocúrtica = distribuição que “não fede nem cheira”, ou seja, a normal mesmo.
📉 Teorema central do limite – ou “a desculpa dos estatísticos para tudo”
O que diz? Se você somar um monte de variáveis aleatórias meio doidas, com algum bom senso (tipo, variância finita), no final das contas a distribuição dessa soma vai se parecer com uma normal.
Ou seja: a distribuição normal é o destino final de qualquer bagunça que seja grande o bastante.
É tipo dizer que, no fim, todo mundo vira estatística — inclusive você.
💡 Em miúdos:
Se você não entendeu metade, tudo bem. Só lembre-se disso:
A distribuição normal é a Beyoncé da estatística. Tem simetria, tem popularidade, tem charme e aparece em tudo que é lugar — de altura humana a erro de medição. E mesmo quando você acha que ela não tá lá… ela tá.
🧬 Estabilidade e a “família normal”: mais unida que reunião de domingo
A distribuição normal é aquela tia estatística que todo mundo conhece, todo mundo chama pra festa, e — surpresa! — ela é boa em somar. Muito boa.
🧮 Estabilidade pela adição: some que dá normal!
Imagine que você tem duas variáveis aleatórias,
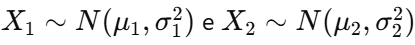
,cada uma cuidando da sua vida, independentes como duas primas que nem se seguem no Instagram.
Agora some as duas: X1+X2.
Resultado? Outra variável normalmente distribuída, como se nada tivesse acontecido.
Tipo genética forte — filhos que nascem com o mesmo nariz da avó.
A fórmula da herança é:
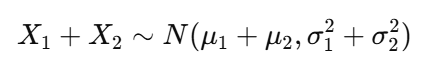
Ou seja, média soma com média, variância soma com variância, e a normalidade permanece firme como um tio conservador.
E isso vale para qualquer número nnn de variáveis normais independentes.
Quer somar 10, 50, 324? Vai dar normal.
É como se a normalidade tivesse um pacto de sangue: entrou na roda, segue a tradição.
🔁 Convolução: o jeito gourmet de somar
Se quiser bancar o refinado, diga que a densidade da soma é a convolução das densidades individuais.
Parece nome de prato francês, mas é só matemática dizendo que você está misturando as curvas como quem bate um smoothie no liquidificador.
Resultado? Outra curva em forma de sino. Sempre.
Mais formalmente, se você convoluir duas densidades normais:
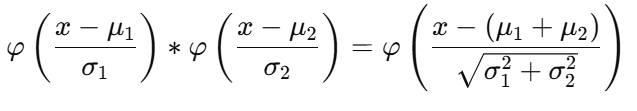
Ou seja, misturou normal com normal? Deu normal. É tipo colocar leite no café com leite.
👪 Família normal: a panelinha das estatísticas
Toda a gangue da normalidade — representada pela função
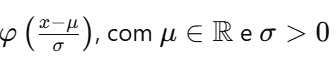
forma o que os matemáticos chamam de família normal.
Mas calma, isso não é o nome de um grupo de WhatsApp.
Essa família é fechada sob convolução, o que quer dizer que qualquer mistura estatística entre eles continua dentro do grupo.
Tipo uma dinastia: você pode até mudar os rostos (média e desvio), mas a realeza é a mesma.
Aliás, tem até um teste de pureza: se você convolui duas funções e continua com a mesma cara de sino, parabéns — você tem uma normal legítima.
Se não… bem, talvez seja hora de investigar a árvore genealógica.
📐 Estabilidade por linearidade: a fórmula que se arruma com qualquer penteado
Multiplicou uma normal por um número? Adicionou uma constante? Tudo bem, ela continua como distribuição normal. Isso se chama estabilidade por linearidade, e diz que:
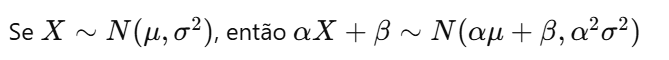
É como dar um tapa no visual da sua distribuição: estica aqui, puxa ali, bota um topete, mas no final ela continua previsível como sempre. Mais estável que muita gente por aí.
📊 Estabilidade pela média: união faz a força (e a média continua normal)
Pegue várias normais independentes e faça a média delas.
Adivinha? Normal de novo! Parece feitiçaria, mas é só a propriedade da estabilidade pela média. A fórmula:
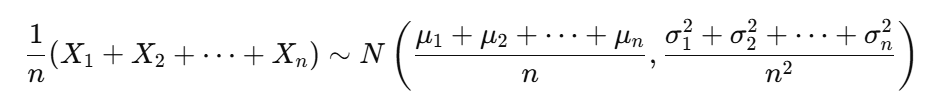
Sim, a variância encolhe (vai pro cantinho pensar na vida), e a média vira média das médias — tudo no mais puro normal possível.
🔥 Entropia: o quanto a distribuição é desorganizada — e a normal reina nisso
Entropia é aquele conceito bonito que parece místico, mas no fundo é só uma medida de quão bagunçada é uma distribuição normal.
Tipo: “o quanto essa variável aleatória não faz ideia de onde vai parar?”.
Agora vem a parte poética (e um pouco irritante, pois é verdadeira): entre todas as distribuições com a mesma variância, adivinha quem tem a maior entropia? Sim, a rainha da estabilidade, a diva das distribuições: a distribuição normal.
Formalmente: se você tem uma variável aleatória contínua X com variância σ², então:
𝐻(X) ≤ ½ log(2πeσ²)
E a igualdade só acontece se X for normal.
Ou seja, nenhuma outra distribuição normal com essa variância consegue ser tão “aleatoriamente desorganizada” de maneira eficiente.
A normal é o caos otimizado. Um tipo de anarquia com manual de instruções.
🧮 Fórmula do caos (versão nerd):
A entropia diferencial da normal N(μ, σ²) é:
𝐻(X) = ½ log(2πeσ²)
Essa fórmula diz, com toda a finesse da matemática, que quanto maior o σ², mais espaço a variável tem pra surtar. E a distribuição normal, claro, surta com precisão milimétrica.
🧊 Convexidade: a normal não é, mas também não se importa
Vamos direto ao ponto: a distribuição normal não é convexa. E sabe o que mais? Ela não tá nem aí.
Aquela desigualdade bonita da teoria da medida, chamada desigualdade de Prékopa-Leindler (ou a versão mais simpática dela, de log-concavidade), não funciona aqui.
A distribuição normal quebra as regras de convexidade com força.
Mas calma: a matemática não se desespera — ela só troca de ferramenta.
Em vez da Prékopa-Leindler, a distribuição normal tem à sua disposição a desigualdade de Ehrhard, que usa uma transformação esperta com a função de distribuição normal inversa.
Tradução:
A desigualdade convexa que vale para o mundo inteiro não vale para a distribuição normal, então a gente fez uma especial só pra ela.
Porque quando você é importante o suficiente, te dão uma regra exclusiva. É tipo a Beyoncé da estatística.
📏 Divergência de Kullback-Leibler: quão diferente você é da normal (bastante)
A divergência de Kullback-Leibler (ou KL, pra quem já desistiu de pronunciar o nome todo) é basicamente o quanto uma distribuição normal mente fingindo que é outra.
Se P é a verdadeira distribuição e Q é a que você quer fingir que é, então:
KL(P‖Q) = ∫ log(p(x)/q(x)) p(x) dx
Se isso dá zero, parabéns: P = Q.
Mas na prática, a divergência quase nunca é zero.
Porque nenhuma distribuição consegue bancar a normal com perfeição — por mais que tente.
A normal como benchmark moral
Se você estiver comparando uma distribuição normal qualquer P com uma normal N(μ, σ²) com a mesma média e variância, então o valor de KL te diz o quanto P é menos eficiente em espalhar incerteza.
Lembra da entropia máxima da normal? A divergência de KL mede o gap entre a entropia da distribuição normal e a entropia da sua distribuição. Em outras palavras:
KL(P‖N) = 𝐻(N) – 𝐻(P)
Se você não for normal, está sempre perdendo entropia — ou seja, você é um pouco menos caótico, um pouco menos livre, um pouco mais entediante.
Triste, mas estatisticamente relevante.
🔄 Ligações com outras distribuições: a distribuição normal como mãe de todas
Se a distribuição normal fosse uma pessoa, seria aquela que diz “não sou só bonita, sou influente”.
Pois praticamente toda distribuição útil em estatística ou é parente direta da normal ou, no mínimo, tem que conversar com ela no Natal.
Vamos por partes.
🧱 Construa outras distribuições com blocos de distribuição normal
A distribuição normal é tipo LEGO.
Junta umas, tira outras, faz umas contas e bam, aparece outra distribuição que você já viu por aí. Vejamos os casos mais importantes:
📊 Distribuição qui-quadrado (χ²)
Se você tiver n variáveis independentes com distribuição N(0,1), e somar os quadrados delas:
χ²(n) = ∑ᵢ Xᵢ²
Parabéns, você criou a distribuição qui-quadrado com n graus de liberdade.
Isso aqui aparece em todo lugar: testes estatísticos, ANOVA, e especialmente nos pesadelos de quem não estudou para a prova.
🎯 Distribuição t de Student
Agora pega uma N(0,1) (vamos chamar de U) e divide pela raiz de uma qui-quadrado independente V normalizada:
T = U / √(V/n)
Resultado? A distribuição t(n).
Ela aparece sempre que você tenta inferir a média com amostras pequenas e ainda tem a cara de pau de dizer “sim, eu sou a correção para quando você não sabe o desvio padrão populacional”.
Quanta audácia.
⚖️ Distribuição de Cauchy
Pegue duas N(0,1) independentes: Z₁ e Z₂. Divida uma pela outra:
C = Z₁ / Z₂
E pronto, você criou a distribuição Cauchy.
Aquela que parece distribuiçãi normal à primeira vista, mas depois se revela o Coringa das distribuições: sem média, sem variância e 100% imprevisível.
💫 Algumas distribuições “escondidas” dentro da normal
📈 Log-normal
Se X ~ N(μ, σ²), então Y = exp(X) é log-normal.
Ou seja: transforma simetria em assimetria com uma simples exponenciação.
Muito útil quando os dados não podem ser negativos, como rendas, tempos de sobrevivência e ego de CEO.
🎲 Box-Muller: sorteando normais com uniformes
Você pode gerar duas normais padrão, X e Y, a partir de duas uniformes U, V ∈ [0,1], com as mágicas fórmulas:
X = √(-2 ln U) · cos(2πV)
Y = √(-2 ln U) · sin(2πV)
Esse é o algoritmo de Box-Muller. Bonito e um lembrete de que até distribuições precisam de um truque para aparecer no mundo digital.
🔁 Outras variações com gosto de normal
🪞 Distribuição normal dobrada
Pega uma N(μ, σ²) e dobra tudo no eixo x = 0.
Só valores positivos, mas mantendo aquele ar de campainha suave.
Muito usada quando os dados têm um limite natural inferior (tipo… 0).
✂️ Distribuição truncada
Você corta a normal nos extremos e reescala.
Porque às vezes a realidade não aceita infinitos valores negativos.
Pense na altura de seres humanos. Ninguém mede -1,73 m, por mais que o modelo ache possível.
🪜 Distribuição de Slash
Misture uma normal com uma uniforme no denominador:
Slash = X / U, com X ~ N(0,1), U ~ U(0,1)
Resultado? Uma distribuição com caudas pesadas, sem vergonha nenhuma de quebrar o seu intervalo de confiança.
💥 Distribuição normal com potência p
Pegue uma N(0,1) e transforme com sign(X)·|X|^p.
Pra p = 1, você volta pra normal.
Pra outros p, você tem algo mais ou menos simétrico, mas mais ou menos ousado.
📦 Generalizações e mutações
A galera da estatística, claro, não resistiu a brincar com a forma da curva:
🧬 Distribuição normal generalizada
Adiciona um parâmetro β para controlar o formato da cauda. β = 2 é a normal. β = 1 é a Laplace (mais pontuda, mais cauda).
Ideal quando você quer modelar dados com picos ou extremos mais intensos que a normal toleraria.
🤹 Distribuição normal assimétrica
Insira um λ de assimetria. λ = 0? Você tem uma normal. λ > 0? Cauda direita pesada. λ < 0? Cauda esquerda.
Pronto, agora sua curva é torta, mas com propósito.
🧠 Multivariada: o poder do conjunto
Agora o nível sobe.
Se você tiver um vetor de variáveis normais (tipo X₁, X₂, ..., Xₙ), o conjunto forma uma distribuição normal multivariada.
A densidade ainda parece uma normal, só que com vetores e matrizes.
Com isso, você calcula probabilidades conjuntas, distribuições condicionais e tudo o que o Teorema de Bayes sonhou.
🍹 Misturas Gaussianas: um coquetel de normais
Quer uma distribuição com múltiplos picos? Misture duas (ou mais) normais com pesos diferentes:
f(x) = λ·N(μ₁, σ₁²) + (1−λ)·N(μ₂, σ₂²)
Boom. Uma mistura gaussiana.
Aparece em aprendizado de máquina, reconhecimento de padrões e em qualquer lugar onde os dados claramente dizem: “uma normal só não me representa.”
Testes de normalidade: como desconfiar educadamente dos seus dados
Antes de sair por aí empurrando distribuições normais goela abaixo dos seus dados, é bom verificar se eles de fato querem brincar de sino.
Existem alguns truques visuais e estatísticos pra isso. Vamos lá:
1. Critérios de normalidade (a.k.a. “olhômetro + calculadora”)
- Primeiro critério: O Santo Histograma Pegue seus dados, faça um gráfico de barras e veja se aparece um sino. Parece o Quasímodo? Parabéns, pode ser normal. Se parecer um camelo de duas corcovas, procure ajuda (ou outro modelo). Mas cuidado: esse método é mais subjetivo do que análise de letra em novela das 8.
- Segundo critério: Faixas de Normalidade Aqui a gente sai do mundo da arte e entra nos números. Se seus dados forem normais:
- 68% vão estar entre a média ± 1 desvio padrão.
- 95% entre a média ± 2 desvios.
- 99,7% entre a média ± 3.
- Terceiro critério: O gráfico da verdade (aka Papel de Henry) Pegue os dados, jogue num papel gaussiano e veja se eles se alinham numa reta. Se sim, ótimo. Se não, jogue o papel no lixo e com ele a suposição de normalidade.
2. Testes de normalidade: pois confiar só na intuição é inocência
Agora que você tentou “sentir” a normalidade dos seus dados, vamos chamar os testes estatísticos — os fiscais da Receita da Estatística.
- Qui-quadrado de Aderência
Agrupe os dados, compare o que esperava com o que veio, e calcule a estatística. É como comparar foto de comida de aplicativo com o prato que chegou. Se a diferença for demais, rejeite a hipótese de normalidade. E sim, os graus de liberdade mudam conforme o quanto você adivinhou dos parâmetros. - Teste de Lilliefors
Versão gourmet do Kolmogorov-Smirnov. Bom pra ver o centro da distribuição normal, mas meio cego nas caudas. Ou seja, ótimo pra julgar livros pela capa. - Anderson-Darling
Esse sim leva as caudas a sério — ou seja, se os extremos do seu gráfico forem os pontos problemáticos, este é seu teste. Menos romântico que o anterior, mas mais confiável. - D’Agostino
Joga a simetria e a curtose na roda e te dá duas estatísticas z. Depois soma tudo e roda um qui-quadrado. Ideal pra quando você já tem muitos dados e nenhum tempo pra fingir que entende gráficos. - Jarque-Bera
Usa os mesmos ingredientes que o D’Agostino (assimetria + curtose), mas exige uma amostra generosa. Se você tiver poucos dados, ele te ignora — feito balada com fila VIP. - Shapiro-Wilk
Queridinho das pequenas amostras. Usa pesos calculados a partir de uma normal teórica e te diz na lata: ou é normal ou tá fora. Rigoroso, direto e sem paciência.
3. Estimando os parâmetros: pois o oráculo aqui é a média
Se você já aceitou que sua distribuição é (ou parece ser) normal, resta saber quais normal. Pra isso, você vai estimar a média (μ) e o desvio padrão (σ), claro.
- Média amostral: Pegue todos os valores, some, divida por n. Parece fácil — e é mesmo. Uma pausa rara na estatística.
- Variância amostral:
Agora complica: subtraia a média de cada valor, eleve ao quadrado, some tudo e divida por n–1. Tudo isso só pra estimar o desvio-padrão, que a gente já sabe que vai ser “mais ou menos”.
Intervalos de confiança: pois ninguém sabe de nada com certeza
- σ conhecido
Beleza, use z. Fórmula clássica: média ± z vezes σ dividido pela raiz de n. Parece saída de horóscopo, mas tem base matemática. - σ desconhecido
Aí entra o famigerado t de Student. Parece com a fórmula anterior, mas o t muda conforme o tamanho da amostra. Menos elegante, mais realista. - Estimando σ quando μ é um mistério
Aqui é fórmula pra nerd com calculadora científica. Usa qui-quadrado, quantis e um monte de números que você provavelmente vai pedir pra um software calcular. Moral da história: ninguém quer fazer isso na mão.
4. Simulação: pois nem tudo se resolve no papel
Quando tudo mais falha (ou você está entediado), simule.
A ideia é gerar números que se comportam como se fossem normalmente distribuídos.
A estatística chama isso de “Monte Carlo”, mas podia se chamar “Chutômetro Premium”.
Métodos duvidosos (não diga que eu não avisei):
- Inversa da normal padrão (Φ⁻¹)
Parece chique, mas é tão eficiente quanto usar régua pra medir nuvem. Lentíssimo. - Soma de 12 uniformes – 6
É tipo aquela receita que diz “dá pra fazer com o que tem em casa”. Funciona mais ou menos. Não espere milagre.
Métodos que funcionam (até onde a gente sabe):
- Box-Muller
Usa seno, cosseno, logaritmo e raiz. Ideal pra quem gosta de matemática e sofrimento. Gera duas N(0,1) de uma vez só. Um luxo. - Marsaglia–Bray
Mesma ideia do Box-Muller, mas sem trigonometria. Menos dor de cabeça, mais velocidade. - Ziggurat
A Fórmula 1 das simulações. Rápido, eficiente e quase impossível de implementar sem vender a alma. Use se estiver em um laboratório da NASA — ou se for masoquista.
Resumo Final:
A normalidade pode até ser o padrão dourado da estatística, mas ela é exigente.
Não basta parecer normal — tem que passar por histograma, papel de Henry, teste qui-quadrado, e sobreviver ao interrogatório completo do Shapiro-Wilk.
E mesmo que passe, sempre vai ter alguém desconfiando.
Porque no fim, seus dados podem ser tudo… menos normais.
Implementado a distribuição normal nos softwares de computação
Distribuição normal… tão onipresente nas ciências quanto café frio em laboratório.
Como não poderia deixar de ser, ela também está por todo lado no mundo dos softwares de computação.
Afinal, se é para sofrer com estatística, que ao menos o Excel faça o trabalho sujo por você.
Planilhas: Excel, LibreOffice, OpenOffice e a arte de fingir que você sabe o que está fazendo
Nas planilhas — esses campos de batalha onde estatísticos e estagiários se encontram — temos funções que fazem mágica com a curva do sino:
LOI.NORMALE(x; mu; sigma; cumulative)(ou o já íntimoNORMDIST): secumulative=FAUX, ele cospe a densidade de probabilidade; secumulative=VRAI, ele entrega a área sob a curva — ou seja, a chance de algo acontecer antes que você perca a paciência.PHI(x): porque nada diz “sou estatístico” como usar letras gregas à toa.LOI.NORMALE.STANDARD(x)(NORMSDIST): distribuições normais com zero de média, um de desvio e 100% de preguiça de parametrizar.LOI.NORMALE.INVERSE(p; mu; sigma): calcula o quantil, ou como gostamos de chamar, “onde o dado está escondido na curva”.CENTREE.REDUITE(x; mu; sigma): simplesmente padroniza, ou seja, coloca todo mundo na mesma régua pra gente poder comparar maçãs com maçãs (e às vezes com abacaxis).
R: o paraíso das distribuições… se você souber digitar
A linguagem S, que vive sua melhor vida dentro do R e do S-PLUS, te dá um arsenal:
dnorm(x): joga a densidade da curva em você. Quer em log?log=TRUE. Porque por que não complicar?pnorm(q): calcula a área acumulada. Pode escolher se quer o lado de cá, o lado de lá ou o valor logarítmico, só não vale reclamar depois.qnorm(p): “quero saber qual valor corresponde a esta probabilidade”. Pronto, a função resolve.rnorm(n): simula n valores normalmente distribuídos. Se a vida fosse normal assim…ks.test(A, "dnorm"): o bom e velho Teste de Kolmogorov-Smirnov, para quando você suspeita que os seus dados são menos normais que sua tia no grupo do WhatsApp.
Matlab / Octave: para quem acha que vetorizar é mais importante que dormir
randn(n)erandn(m, n): você quer números aleatórios normalmente distribuídos? Toma! Quer em matriz? Toma também!normcdf,normpdf: a sopa de letrinhas de sempre — função acumulada, densidade, tudo ali na bandeja.normfit(X): dá média e desvio de um conjunto de dados. Mais simples que isso, só a calculadora do seu avô.
Scilab: o irmão mais pobre, mas esforçado
Gratuito, francês e funcional — Scilab é o vinho barato dos softwares estatísticos. Ele tem:
rand(m, n, "normal"): aleatoriedade em forma matricial.grand(m, n, "nor", mu, sigma): mesma coisa, mas com especificação de parâmetros — porque normal não precisa ser sempre padrão.cdfnor,pdfnormal,idfnormal,rndnormal: funções com nomes explicativamente feios, mas que fazem o serviço. Quer quantil? Quer PDF? Quer gerar dados falsos como um bom cientista de dados? Tá tudo aí.
Homenagem: pois até a curva normal merece um troféu de participação
Não bastava dominar estatísticas, testes, planilhas, simulações, agora a bendita curva da distribuição normal também é celebrada como ícone pop acadêmico.
Galton idolatrava a distribuição normal como se fosse uma divindade da ordem em meio ao caos (ele não estava completamente errado).
E Gauss, claro, virou estampa de cédula — porque nada diz “contribuí para a ciência” como virar dinheiro.
Até William Youden, em 1962, resolveu se empolgar e fez um caligrama em forma de sino (é sério).
E com isso a curva da distribuição normal deixou de ser só um gráfico para virar quase uma entidade espiritual da estatística.
Conclusão?
Se você não entendeu nada até aqui sobre distribuição normal, parabéns, você está exatamente onde 90% das pessoas estão quando abrem o Excel e digitam =NORM.INV sem saber o que raios estão invocando.
Mas a curva da distribuição normal está lá, paciente, suave, com sua barriga de sino e caudas longas, esperando você cometer um erro estatístico em seu nome.
Você pode me seguir no Instagram e no YouTube para ver mais piadas toscas e deprimentes.
Siga também o grupo de comédia mais paia do mundo.


